
Ввод, вывод и сообщения об ошибках
До этого команды показывали результат прямо в терминале. Для сопровождения такой результат часто нужно сохранить: передать коллеге, сравнить с другим моментом или обработать следующей программой. Тогда важным становится различие между обычными данными и сообщением о неудаче. Если положить их в один файл без объяснения, следующая команда может принять ошибку за строку полезной таблицы.
В Linux программа обычно получает стандартный ввод и два стандартных выхода. Их принято обозначать номерами 0, 1 и 2: stdin, stdout и stderr. Имена описывают назначение, а не обязательное устройство. Ввод может прийти из файла, обычный выход — уйти в следующую программу, а ошибки — сохраниться отдельно. Оболочка связывает эти потоки при запуске команды.
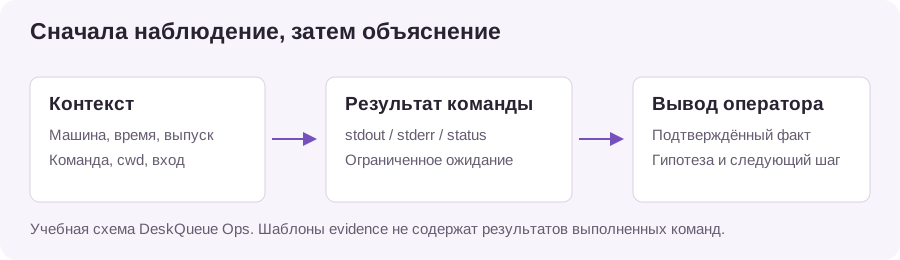
Учебная схема связывает поток с контекстом наблюдения. В последующих главах сохраняем все три части результата: данные, сообщения и статус.
Один результат в двух местах
Откройте лабораторию и прочитайте первые строки учебного журнала. Пока вывод короткий и предназначен только для наблюдения. Затем сохраните такой же срез в evidence. Это небольшая операция записи в нашей рабочей папке, которая не изменяет исходную таблицу.
head -n 5 fixtures/access.tsv
head -n 5 fixtures/access.tsv > evidence/access-head.tsv
cat evidence/access-head.tsv
Обозначение > направляет stdout в файл. Если файл существует, его содержимое обычно заменяется; если отсутствует, создаётся новый. Поэтому имя результата нужно выбирать осознанно. Не направляйте вывод в исходный журнал: оболочка может открыть и обнулить файл ещё до того, как программа начнёт его читать. Потерянный вход затем невозможно восстановить из пустого результата.
Для накопления строк существует >>, но такой режим тоже требует договора. Повторное выполнение команды может добавить тот же срез второй раз. Когда строим снимок одного наблюдения, удобнее отдельное имя или явное перезаписывание. Когда ведём историю событий, добавление может быть правильным. Ни один оператор сам не понимает, какой вид данных вы собираете.
Ошибка не становится таблицей
Попробуйте прочитать отсутствующий учебный файл, сохраняя потоки раздельно. Этот пример нужен для понимания механизма. В отчёте следует отметить, что отсутствие создано намеренно, а не найдено на сервере.
head -n 5 fixtures/missing.tsv > evidence/missing.out 2> evidence/missing.err
printf 'exit=%s\n' "$?"
Ожидается пустой обычный вывод, сообщение в missing.err и ненулевой статус завершения. Точный текст зависит от языка окружения. Переменная $? относится к последней завершившейся команде, поэтому мы читаем её сразу. Если между head и этим чтением выполнить другую успешную команду, статус исходной ошибки будет уже потерян.
Сообщение и статус дополняют друг друга. Статус позволяет программе выбрать ветку, а текст помогает человеку понять причину. Пустой stderr ещё не доказывает успех: некоторые программы сообщают о результате другим способом. И наоборот, диагностическое предупреждение может появиться при нулевом статусе. Договор конкретного инструмента нужно читать в его справке, а не выводить из цвета текста в терминале.
Порядок перенаправлений
Иногда требуется общий файл, содержащий обычный вывод и ошибки. Оператор 2>&1 связывает stderr с текущим назначением stdout. Порядок имеет значение, потому что оболочка обрабатывает перенаправления последовательно. Это можно увидеть на двух простых учебных сообщениях без обращения к службе.
bash -c 'printf "data\n"; printf "problem\n" >&2' > evidence/combined.txt 2>&1
bash -c 'printf "data\n"; printf "problem\n" >&2' 2>&1 > evidence/separate.txt
В первом случае оба потока ожидаемо попадут в combined.txt. Во втором stderr сначала связывается с прежним stdout, обычно терминалом, а затем только stdout переводится в файл. Поэтому сообщение problem остаётся на прежнем выходе. В справке Bash этот механизм описан в разделе перенаправлений.
Общий файл удобен для человеческого просмотра хода одной операции. Для автоматического чтения данных он может быть неудобен: строка ошибки нарушит табличный формат. В DeskQueue Ops сохраняем машинный результат и сообщения отдельно, а в кратком описании связываем их именами. Это даёт возможность повторно обработать данные, не очищая их вручную от случайных диагностических строк.
Поток передаётся следующей команде
Конвейер соединяет stdout одной команды со stdin следующей. Например, можно выбрать столбец учебной таблицы, отсортировать значения и найти их частоты. Сами преобразования разберём отдельно; сейчас сосредоточимся на соединении программ.
cut -f 2 fixtures/access.tsv | sort | uniq -cКаждый участник выполняет небольшую задачу и отдаёт текст дальше. Это отличается от цепочки отдельных команд с промежуточными файлами: данные передаются потоком. Однако при ошибке первой команды последняя может успешно обработать пустой ввод. Без дополнительных настроек статус конвейера обычно определяется последней командой. На уроке о сценариях разберём pipefail и явную обработку отказов.
Не направляйте stderr в конвейер автоматически, если следующая программа ожидает данные. Это может скрыть исходную неудачу: строка «файл отсутствует» станет обычным элементом сортировки. Наблюдатель увидит красивый результат и решит, что обработка прошла нормально. Сначала определите назначение потока, затем решите, должно ли сообщение участвовать в преобразовании.
Сохранить и продолжить чтение
Команда tee копирует стандартный ввод в файл и одновременно передаёт его дальше в stdout. Такой приём удобен, когда результат нужен и на экране, и в документе наблюдения. В нашем примере сохраним короткий срез, а последняя команда посчитает его строки.
head -n 5 fixtures/access.tsv | tee evidence/first-five.tsv | wc -lОжидаем число 5, потому что подготовленная таблица длиннее пяти строк. Оно относится к срезу, а не ко всему журналу. Если входной файл короче, результат закономерно будет меньше. Также учитывайте заголовок: одна из строк содержит имена полей. Прежде чем сравнивать числа с количеством запросов, договоритесь, включается ли заголовок в наблюдение.
Режим tee -a добавляет данные к существующему файлу. В этой лаборатории он понадобится только там, где история явно задумана. Для снимка одного состояния обычное перезаписывание проще проверить. Не превращайте каждый промежуточный результат в постоянно растущий журнал: через несколько повторений станет неясно, какие строки принадлежат какому запуску.
Результат урока — несколько именованных файлов в evidence и понимание того, какой поток содержит каждый из них. Вы умеете сохранить результат, отдельно увидеть отказ и объяснить порядок перенаправления. Следующий шаг покажет, как читать большой текст выборочно, чтобы диагностическая папка не заполнялась бесполезными полными копиями журналов.